树上最近祖先LCA
1.暴力
这个不用多说了,就是两点同时暴力向上跳,时间复杂度
int lca( int x,int y )
{
	while( x != y )
		if( dep[x] >= dep[y] ) x=fa[x];
		else                   y=fa[y];
	return x;
}
2.倍增
考虑方法1的时间开销在哪里,可以很快的想到暴力向上跳跃的太暴力了(废话),于是我们可以考虑一次多跳一点
于是可以二进制拆分倍增跳跃降时间将至,跟序列上的匹配问题倍增优化思路相近
预处理,单次查询,思路清晰且实现简洁,但是常数较大,有时会被卡掉
void dfs( int p,int Fa )//预处理倍增数组
{
	fa[0][p]=Fa, dep[p]=dep[Fa]+1;
	for( int i=1;( 1<<i )<=dep[p];i++ )//用倍增思想倍增处理数组
		fa[i][p]=fa[i-1][fa[i-1][p]];
	for( auto &x:rode[p] )
		if( x != Fa )
			dfs( x,p );
}

int lca( int x,int y )
{
	//k是深度的log值,也是倍增存在意义的最大值
	if( dep[x] <= dep[y] ) swap( x,y );
	for( int i=k;i>=0;i-- )//先处理到同深度
		if( dep[fa[i][x]] > dep[y] )
			x=fa[i][x];
	for( int i=k;i>=0;i-- )//两点同时向上跳
		if( fa[i][x] != fa[i][y] )
			x=fa[i][x], y=fa[i][y];
	return fa[0][x];//他们现在的父亲就是原两点的lca
}
3.树链剖分
树链剖分是通过将将树分割成若干条链的形式,以维护树上路径的信息
在这之前,我们先明确一些树链剖分中会出现的名词
1.重儿子:儿子节点中儿子数量最多的节点

2.轻儿子:除重儿子以外的儿子节点

*tips:叶子节点不存在儿子自然也没有轻/重儿子

3.重边:连接任意两个重儿子的边

4.轻边:非重边就是轻边

5.重链:相邻重边连起来的链接一条重儿子的链

*tips:对于叶子节点,若其为轻儿子,则有一条以自己为起点的长度为1的链

*tips:每一条重链以轻儿子为起点,树上每个结点都属于且仅属于一条重链
不断向上跳重链,当跳到同一条重链上时,深度较小的结点即为
向上跳重链时需要先跳所在重链顶端深度较大的那个
时间复杂度预处理,单次查询,树剖常数小且一般跑不满,比倍增优秀但是代码实现与理解上不太友好
void dfs1( int p,int Fa )//第一次dfs处理重儿子
{
    siz[p]=1;
    dep[p]=dep[Fa]+1, fa[p]=Fa;
    for( auto &x:rode[p] )
    {
        if( x == Fa ) continue;
        dfs1( x,p );
        siz[p]+=siz[x];
        if( siz[x] > siz[mson[p]] ) mson[p]=x;//记录重儿子
    }
}

void dfs2( int p,int t )//第二次dfs处理重链
{
    top[p]=t;//记录所在重链的重链顶
    if( !mson[p] ) return ;//到了叶子结点,返回
    dfs2( mson[p],t );//继续跳重儿子分剖分重链
    for( auto &x:rode[p] )
        if( x != fa[p] && x != mson[p] )
            dfs2( x,x );//每一个轻儿子都有一条从自己出发的链
}

int lca( int x,int y )
{
    while( top[x] != top[y] )//重复至跳直到到同一条重链上
    	//优先跳重链顶深度较大的
        if( dep[top[x]] > dep[top[y]] ) x=fa[top[x]];
        else                            y=fa[top[y]];
    return ( dep[x] < dep[y] ? x : y );//深度较小的就是LCA
}
tips!!!
对于第二次dfs处理重链时,我们以"重儿子是0"判断是否是叶节点,同时直接跳出该重链的划分
这个时候一些人就会想到,在重链剖分的时候,不能存在节点编号为0,否则就会产生错误的剖分
具体表现就是节点0所在的重链在节点0以下的部分全部不会被划分进该重链
4.tarjan
强大的是,塔杨老爷爷现在还活着
因为这个是我最熟悉的求法,所以它就是最简单的方法
求是一种离线的算法,其中心是将节点及其所有父亲划分在同一组内,两点的第一个相交的父亲就是他们的
分组操作就是并查集的经典合并完成,而判断相交就是判断同组了,这些都会在dfs的过程中被求得
每次时间复杂度快到飞起,但是因为离线算法操作被限制,而且对于大部分人来说不能理解,所以大家平时还是尽量使用树剖
void tarjan( int p )
{
    vis[p]=false;//标记已访问过,O(n)的基准
    for( auto x:rode[p] )//枚举所以可达点
    {
        if( !vis[x] ) continue;
        tarjan( x );//先递归,保证是从叶子节点向上依次合并
        merge( x,p );//合并父子,注意要把父亲设置为深度最浅的父亲,也就是p
    }
    for( auto &[x,idx]:ask[p] ) if( !vis[x] ) ans[idx]=get( x );
    //枚举与其相关的所有询问,如果对应点被查询过了,那么答案就是他的最远父亲
}
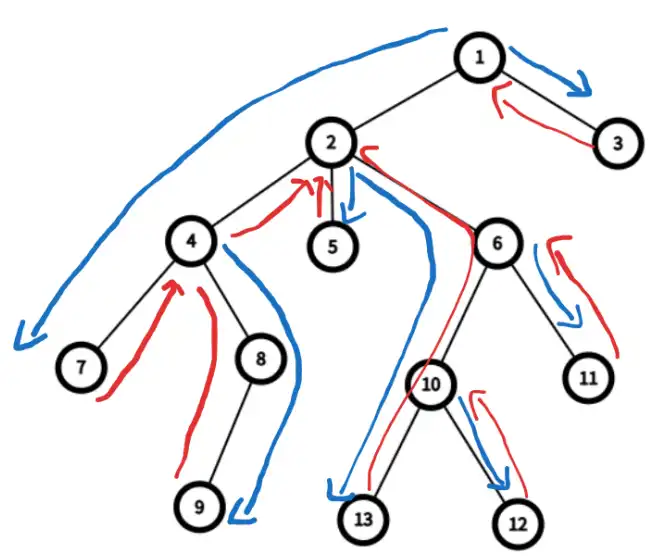
可能确实不好理解(但是我一遍看懂了,很神奇),这里附上例子与图片帮助理解(蓝线表示dfs顺序,红线表示合并顺序)
例如我们要查询9和11的,在遍历到11前,9已经依次向上以9->8->4->2的顺序合并完成
而当的时候,以该点为根的子树并不存在11,所以不会遍历到11(废话)
而当根为2时,我们遍历到了11,说明我们在以2为根的子树中发现同时存在9和11,所以2就是他们的,对于其他的查询同理
从这里不难看出,其实就是寻找根深度最深的同时存在查询的两点的子树,而这个根就是他们的,合并操作就是将一颗子树内的所有节点合并
UPDATA: 2026.09.08 增加欧拉序和dfn序求LCA的思路解法
5.欧拉序
我们首先看一下上面的那个图,这张图其实就把我们的这个欧拉序构造出来了
然后我们根据欧拉序的得到可以知道:两点的一定在两数第一次欧拉序位置的中间且为最小值
因为如果是和的,遍历顺序一定是->->->,我们写个ST表就可以做了
时间复杂度:预处理,查询
inline void dfs( int p,int fa )//先dfs求欧拉序
{
	dfn[p]=++id; Euler[id]=p;
	for( auto &x:rode[p] ) if( x != fa )
	{
		dep[x]=dep[p]+1;
		dfs( x,p );
		Euler[++id]=p;
	}
}

inline void init()//预处理ST表
{
	lg2[0]=-1;
	for( int i=1;i<=idx;i++ ) lg2[i]=lg2[i>>1]+1;
	for( int i=1;i<=idx;i++ ) ST[0][i]=Euler[i];
	for( int bit=1;bit<=lg2[idx];bit++ ) for( int i=1;( i+( 1<<bit ) )<=idx;i++ )
		if( dep[ST[bit-1][i]] < dep[ST[bit-1][i+( 1<<bit-1 )]] ) ST[bit][i]=ST[bit-1][i];
		else                                                     ST[bit][i]=ST[bit-1][i+( 1<<bit-1 )];
}

inline int lca( int x,int y )//用ST表查询
{
	x=dfn[x]; y=dfn[y];
	if( dfn[x] > dfn[y] ) swap( x,y );
	int lg=lg2[y-x+1];
	if( dep[ST[lg][x]] < dep[ST[lg][y-( 1<<lg )+1]] ) QAQ ST[lg][x];
	else                                              QAQ ST[lg][y-( 1<<lg )+1];
}
6.dfn序
和欧拉序相比,序的区别就是序中他们的一定出现在它们之前
那我们记录为父亲然后比较序再就可以了
inline void dfs( int p,int fa )//先dfs求dfn序
{
	dfn[p]=++id; ST[0][dfn[p]]=fa;
	for( auto &x:rode[p] ) if( x != fa )
		dfs( x,p );
}

inline void init()//预处理ST表
{
	lg2[0]=-1;
	for( int i=1;i<=idx;i++ ) lg2[i]=lg2[i>>1]+1;
	for( int bit=1;bit<=lg2[n];bit++ ) for( int i=1;( i+( 1<<bit ) )<=idx;i++ )
		if( dfn[ST[bit-1][i]] < dfn[ST[bit-1][i+( 1<<bit-1 )]] ) ST[bit][i]=ST[bit-1][i];
		else                                                     ST[bit][i]=ST[bit-1][i+( 1<<bit-1 )];
}

inline int lca( int x,int y )//用ST表查询
{
	if( x == y ) QAQ x;
	x=dfn[x]; y=dfn[y];
	if( dfn[x] > dfn[y] ) swap( x,y );
	int lg=lg2[y-x+1];
	if( dep[ST[lg][x]] < dep[ST[lg][y-( 1<<lg )+1]] ) QAQ ST[lg][x];
	else                                              QAQ ST[lg][y-( 1<<lg )+1];
}